پردازش زبان طبیعی چیست و چرا فارسی برایش سخت است
از غلطگیرِ کیبورد تا ترجمه و خلاصهسازی، همه زیرِ یک چتر به اسمِ NLP کار میکنند. اینجا با مثالهای فارسی میبینیم ماشین چطور زبان را میفهمد و کجا هنوز گیر میکند.
کیبوردِ گوشیات وقتی «میرم» را به «میروم» پیشنهاد میدهد، گوگل وقتی «هوای تهران فردا» را بدونِ علامتِ سؤال میفهمد، و اپِ بانک وقتی پیامِ «کارتم رو مسدود کن» را به بخشِ درست میفرستد، همه دارند یک کار میکنند. اگر بپرسی پردازش زبان طبیعی چیست، جوابِ کوتاهش همین است: یادِ ماشین دادن که زبانِ آدمها را بخواند، بفهمد و بنویسد.
جوابِ بلندش جالبتر است، مخصوصاً برای ما که فارسی حرف میزنیم. زبانی که نیمفاصله دارد، از راست به چپ نوشته میشود، و بینِ «دارم میرم» و «در حالِ رفتن هستم» یک دنیا فاصله دارد. این مقاله توضیح میدهد NLP چه کارهایی میکند، چرا فارسی برایش سخت است، و چه چیزی در چند سالِ اخیر عوض شد.
اگر هنوز تصویرِ روشنی از کلِ ماجرا نداری، اول نگاهی به هوش مصنوعی چیست بینداز؛ NLP یکی از شاخههای همان درخت است، شاید پرکاربردترینش.
پردازش زبان طبیعی چیست، با مثالهایی که هر روز میبینی
«طبیعی» در این اسم یعنی زبانی که آدمها با آن حرف میزنند، در برابرِ زبانهای ساختگی مثلِ زبانهای برنامهنویسی. کامپیوتر زبانِ پایتون را بیاشتباه میفهمد چون قواعدش کامل و بیاستثناست. زبانِ فارسی اینطور نیست. «شیر» میتواند حیوان باشد، نوشیدنی یا شیرِ آب؛ و فقط جملهی کنارش میگوید کدام.
پس NLP در اصل هنرِ کنار آمدن با ابهام است. ماشین باید از روی زمینه حدس بزند، و هر چه زمینه را بهتر ببیند، حدسش بهتر است. تقریباً همهی پیشرفتهای این حوزه را میشود با همین یک جمله خلاصه کرد: ماشینها یاد گرفتند زمینهی بزرگتری را ببینند.
کارهای اصلی NLP
اسمها فنیاند ولی کارها آشنا. این جدول مهمترینها را کنارِ یک مثالِ ایرانی گذاشته و گفته هر کدام امروز روی فارسی چقدر جواب میدهد:
| کار | مثالِ فارسی | وضعیت روی فارسی |
|---|---|---|
| ترجمه | برگرداندنِ ایمیلِ مشتریِ آلمانی به فارسی | خوب برای متنِ عمومی، ضعیف در اصطلاحِ تخصصی |
| خلاصهسازی | خلاصهی بخشنامهی بیستصفحهای اداره | خوب، به شرطِ بازخوانیِ عددها |
| تحلیلِ احساس | فهمیدنِ حالِ کلیِ نظرهای یک رستوران در اسنپفود | متوسط؛ کنایه را اغلب نمیگیرد |
| تشخیصِ گفتار | تبدیلِ ویسِ تلگرام به متن | خوب برای لهجهی تهرانی، ضعیفتر برای لهجههای دیگر |
| استخراجِ اطلاعات | بیرون کشیدنِ نام و مبلغ از فاکتور | خوب در قالبهای تکراری |
| دستهبندیِ متن | جدا کردنِ آگهیهای دیوار به دستهی درست | خوب |
ترجمهی ماشینی قدیمیترین رؤیای این حوزه است و راهنمای عملیاش در ترجمه با هوش مصنوعی آمده. برای ویس و فایلِ صوتی هم تبدیل گفتار به متن فارسی جزئیاتِ بیشتری دارد.
چرا فارسی برای ماشین سخت است
فارسی زبانِ سختی نیست؛ برای ماشین سخت است، و این دو فرق دارند. چهار دلیلِ اصلی:
نیمفاصله
«میروم» را یکی با نیمفاصله مینویسد، یکی با فاصله، یکی چسبیده: «میروم». برای آدم هر سه یکی است. برای ماشینی که متن را به تکههای کوچک میشکند، این سه میتوانند سه چیزِ کاملاً متفاوت باشند. «کتابها» و «کتاب ها» هم همینطور. متنِ فارسیِ اینترنت پر از این ناهمگونی است و مدل باید یاد بگیرد همه را یکی ببیند.
کلمههای چسبان
«نمیخواستمش» یک کلمه است ولی چهار تکه معنا دارد: نفی، فعل، زمانِ گذشته، ضمیرِ مفعولی. انگلیسی همین را با سه کلمهی جدا میگوید. ماشین باید این تکهها را از هم باز کند تا بفهمد جمله دربارهی چیست. نحوهی تکهتکه شدنِ متن در توکن چیست باز شده و دلیلِ این را هم میگوید که چرا متنِ فارسی معمولاً تکههای بیشتری از هممعنیِ انگلیسیاش میگیرد.
محاوره در برابرِ رسمی
«اینو واسه فردا آماده میکنی؟» و «آیا این را برای فردا آماده خواهید کرد؟» یک پیاماند. ولی کلمهها تقریباً هیچ اشتراکی ندارند. بیشترِ متنِ رسمیِ فارسی کتاب و خبر است و بیشترِ متنِ محاوره در پیامرسانها، که در دسترسِ سازندگانِ مدل نیست. نتیجه: ابزارها رسمی را بهتر از محاوره میفهمند، درست برعکسِ چیزی که کاربر مینویسد.
راستبهچپ و متنِ آمیخته
جملهای مثلِ «نسخهی 3.2 را روی ویندوز نصب کن» فارسی، عدد و انگلیسی را قاطی دارد. نمایشش روی صفحه گاهی بههم میریزد و در استخراجِ متن از PDF، ترتیبِ کلمهها گاهی برعکس درمیآید. این دیگر مشکلِ فهم نیست، مشکلِ لولهکشی است؛ ولی نتیجهاش همان جوابِ خراب است.
وقتی متنِ فارسی به ابزاری میدهی، نیمفاصلهها را درست کن و اگر متن محاورهی سنگین است، یک جمله بنویس که «این متن محاورهای است». همین توضیح، خطای برداشت را کم میکند. فهرستِ کاملترِ این ترفندها در محدودیتهای فارسی در هوش مصنوعی آمده.
از قاعدهنویسی تا مدلهای زبانی
NLP سه دورهی بزرگ را پشت سر گذاشته و فهمیدنِ این سه، توضیح میدهد چرا ابزارهای امروز اینقدر با ابزارهای ده سالِ پیش فرق دارند.
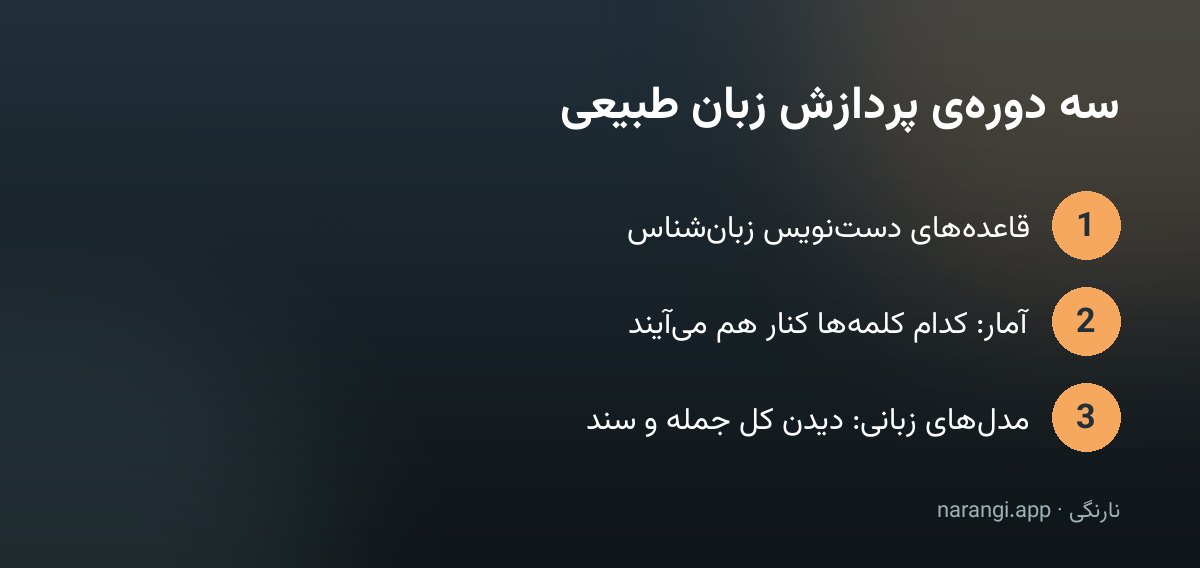
دورهی قاعدهها. زبانشناس مینشست و قانون مینوشت: اگر کلمه با «می» شروع شد و به «م» ختم شد، فعلِ اولشخص است. این روش دقیق بود ولی شکننده. هر استثنا یک قانونِ تازه میخواست و فارسی پر از استثناست.
دورهی آمار. بهجای قانون، ماشین از روی متنهای زیاد شمرد که کدام کلمهها معمولاً کنارِ هم میآیند. غلطگیرهای املایی و ترجمههای ماشینیِ اولیه از این نوع بودند. بهتر بودند، ولی جمله را تکهتکه میدیدند، نه کامل.
دورهی مدلهای زبانی. از حدودِ سالِ ۲۰۱۷ و معرفیِ معماریِ ترنسفورمر، ماشین توانست کلِ جمله و بعدها کلِ سند را یکجا ببیند و بفهمد کدام کلمه به کدام مربوط است. مروری بر تاریخچهی پردازش زبان طبیعی در ویکیپدیا این سیر را با جزئیاتِ بیشتر آورده. حالا یک مدلِ واحد هم ترجمه میکند، هم خلاصه، هم تحلیلِ احساس؛ دیگر لازم نیست برای هر کار ابزارِ جدا ساخت. توضیحِ دقیقترش را در مدل زبانی بزرگ چیست نوشتهایم.
تحلیلِ احساس: جایی که ماشین طعنه را نمیفهمد
فرض کن صاحبِ یک کافه در شیرازی و صدها نظر زیرِ صفحهات جمع شده. تحلیلِ احساس میتواند بگوید کلاً مردم راضیاند یا نه، و بیشترِ گلایهها دربارهی قیمت است یا سرعت. این کار را خوب انجام میدهد.
ولی جملهای مثلِ «دستتون درد نکنه، فقط یک ساعت منتظر موندیم» را ممکن است مثبت حساب کند. «دستتون درد نکنه» مثبت است؛ طعنه در لحن است، نه در کلمه. مدلهای تازه این را بهتر از قبل میگیرند، ولی نه همیشه. قاعدهی عملی: روی جمع حساب کن، روی تکجمله نه. برای روشِ کار با نظرهای واقعی، تحلیل نظرات مشتری را ببین.
یک پرامپت برای امتحانِ NLP روی متنِ خودت
لازم نیست برنامهنویس باشی تا این کارها را ببینی. یک ابزارِ چتِ هوش مصنوعی همهی کارهای بالا را انجام میدهد. این پرامپت را با یک متنِ واقعی از کارِ خودت امتحان کن:
متنِ زیر نظرِ مشتریهای یک فروشگاهِ اینترنتی است.
۱. هر نظر را مثبت، منفی یا خنثی برچسب بزن.
۲. اگر نظری طعنه یا کنایه دارد، جدا علامت بزن و بگو چرا.
۳. سه گلایهی پرتکرار را با یک جمله توضیح بده.
۴. جایی که مطمئن نیستی، بنویس «مطمئن نیستم»؛ حدس نزن.
[نظرها را اینجا بچسبان]بندِ چهارم مهم است. مدلهای زبانی وقتی مطمئن نیستند هم با اطمینان جواب میدهند، مگر اینکه صریحاً اجازهی «نمیدانم» گرفته باشند. میتوانی همین حالا در نسخهی وبِ نارنگی امتحانش کنی.
کجاها هنوز جواب نمیدهد
صادقانه بگوییم: NLPِ فارسی خیلی جلو آمده ولی چند جا هنوز لنگ میزند.
- لهجهها و گویشها. ویسِ کسی با لهجهی غلیظِ کردی یا گیلکی را تشخیصِ گفتار معمولاً پر از خطا به متن تبدیل میکند.
- متنِ کهن. نثرِ قاجاری یا شعرِ سبکِ هندی را میخواند ولی گاهی معنا را با اطمینان غلط میگوید.
- اصطلاحِ تخصصیِ ایرانی. «سرقفلی»، «قولنامه» یا اصطلاحهای ادارهی مالیات را گاهی با معادلِ خارجیشان قاطی میکند.
- عدد و تاریخ. در خلاصهسازی، تبدیلِ تاریخِ شمسی یا جابهجا شدنِ یک رقم کم نیست. عددها را همیشه با اصل مقایسه کن.
هیچکدام از اینها دلیل نمیشود ابزار را کنار بگذاری. فقط یعنی خروجی پیشنویس است و آخرین نگاه باید مالِ خودت باشد.
جمعبندی
پردازش زبان طبیعی یعنی کنار آمدنِ ماشین با ابهامِ زبانِ انسان، و فارسی با نیمفاصله، کلمههای چسبان و فاصلهی بزرگِ محاوره و رسمی، این ابهام را بیشتر میکند. مدلهای زبانی بخشِ بزرگی از این مشکل را حل کردهاند: ترجمه، خلاصه و دستهبندی امروز واقعاً بهدردبخورند. تحلیلِ احساس و گفتار روی لهجهها هنوز محتاطانه استفاده میشوند. متن را تمیز بده، زمینه بگو، و عددها را خودت چک کن.
مطالب مرتبط: