مدل زبانی بزرگ چیست؛ از حدسِ کلمه تا مدلِ استدلالی
پشتِ هر چتباتی که با آن حرف میزنی یک مدلِ زبانیِ بزرگ است. اینجا میبینیم چطور ساخته میشود، حافظهاش کجا تمام میشود، چرا فارسی را کمتر بلد است و مدلهای «فکرکننده» چه فرقی دارند.
اگر به یک چتبات بنویسی «پایتختِ استرالیا» و جواب بدهد «کانبرا»، به نظر میرسد جواب را از جایی پیدا کرده. پیدا نکرده. کلمه به کلمه ساخته، و در هر قدم حدس زده محتملترین ادامه چیست. پاسخِ کوتاهِ سؤالِ «مدل زبانی بزرگ چیست» همین است: ماشینی که در حدس زدنِ کلمهی بعدی آنقدر خوب شده که میتواند نامه بنویسد، کد بزند و مسئله حل کند.
عجیب است که چنین سازوکارِ سادهای اینقدر کار انجام دهد. و همین سادگی توضیح میدهد چرا گاهی اینقدر عجیب اشتباه میکند. این مقاله روی خودِ مدلهای زبانی تمرکز دارد؛ تصویرِ کلیترِ اینکه همهی مدلهای هوش مصنوعی چطور کار میکنند در مدلهای هوش مصنوعی چطور کار میکنند آمده و اینجا تکرارش نمیکنیم.
اگر هم تازهکاری و میخواهی بدانی این همه کجای نقشهی بزرگتر است، از هوش مصنوعی چیست شروع کن.
مدل زبانی بزرگ چیست: ماشینِ حدسِ کلمهی بعد
جملهی «امروز صبح توی ترافیکِ همت گیر…» را کامل کن. احتمالاً «کردم» یا «افتادم». هیچکس «زرافه» نمیگوید. مغزِ تو از هزاران جملهای که شنیده میداند چه کلمهای اینجا مینشیند. مدلِ زبانی همین کار را میکند، ولی با حجمِ متنی که هیچ آدمی در صد عمر هم نمیخواند.
«بزرگ» در اسمش به دو چیز اشاره دارد: حجمِ متنی که دیده، و تعدادِ «پیچهای قابلِ تنظیم» داخلش که به آنها پارامتر میگویند. هر چه این پیچها بیشتر، الگوهای ظریفتری را میتواند نگه دارد. نکتهی جالب این است که از یک حدی به بعد، مدل کارهایی را یاد گرفت که کسی مستقیم یادش نداده بود، مثلِ ترجمه یا نوشتنِ کد، فقط چون این کارها برای حدسِ بهترِ کلمهی بعد لازم بودند.
یک نکتهی فنیِ کوچک: مدل دقیقاً با «کلمه» کار نمیکند، با تکههایی به اسمِ توکن. یک کلمهی فارسی ممکن است چند توکن باشد. اینکه این تکهها چطور ساخته میشوند و چرا روی هزینه اثر دارند در توکن چیست آمده.
دو مرحلهی ساخت: پیشآموزش و تنظیم
پیشآموزش: خواندنِ همهچیز
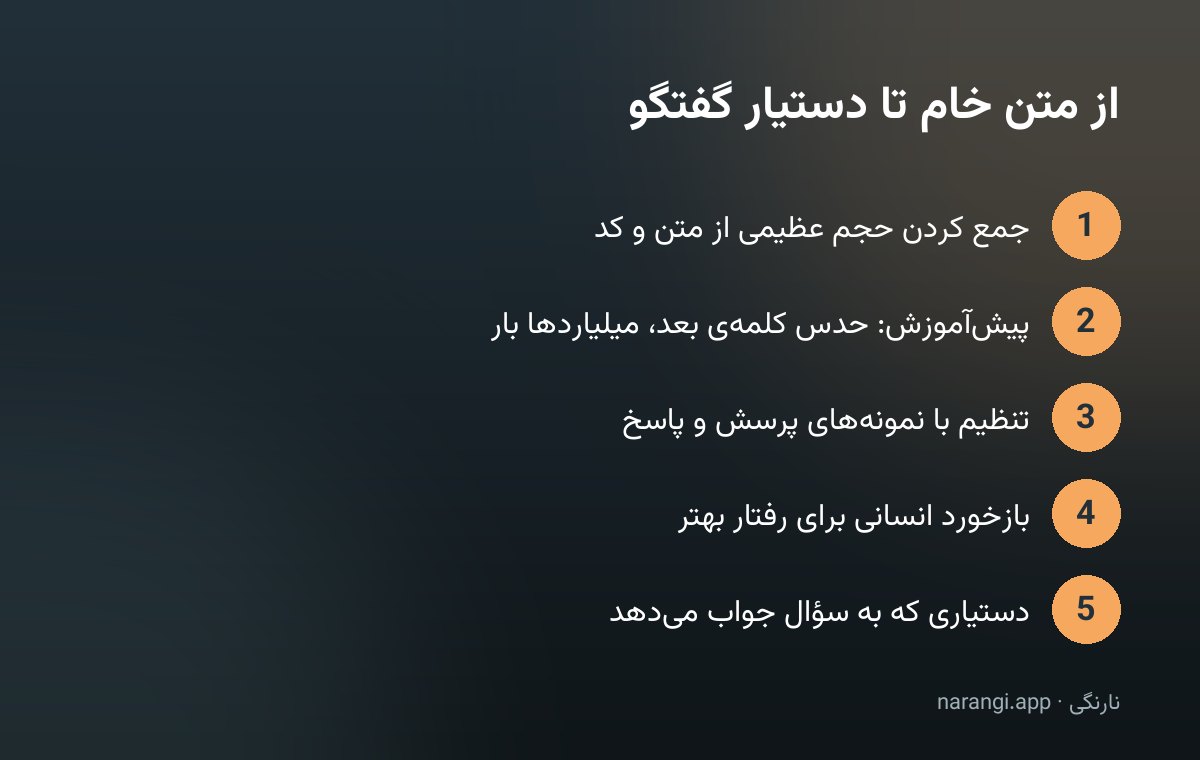
در مرحلهی اول، مدل حجمِ عظیمی از متنِ اینترنت، کتاب و کد را میخواند و فقط یک کار میکند: حدسِ کلمهی بعد، اشتباه کردن، و کمی اصلاح. میلیاردها بار. این مرحله گرانترین بخش است و ماهها روی هزاران پردازندهی گرافیکی طول میکشد.
خروجیِ این مرحله هنوز دستیار نیست. اگر بنویسی «چطور کیک درست کنم؟» ممکن است بهجای جواب، سه سؤالِ دیگر مثلِ آن را ادامه بدهد، چون در اینترنت چنین فهرستهایی زیاد است. مدل ادامهدادن را بلد است، نه جوابدادن را.
تنظیم: یاد گرفتنِ رفتار
در مرحلهی دوم، با نمونههای پرسش و پاسخِ باکیفیت و با بازخوردِ آدمها، مدل یاد میگیرد مثلِ یک دستیار رفتار کند: به سؤال جواب بدهد، مؤدب باشد، و از بعضی کارها سر باز بزند. این مرحله دانشِ تازهی زیادی اضافه نمیکند؛ بیشتر شیوهی رفتار را شکل میدهد. شبیهِ فارغالتحصیلی که همهچیز خوانده و حالا یاد میگیرد پشتِ میزِ مشاوره چطور حرف بزند.
پنجرهی زمینه: حافظهی کوتاهمدت
مدل در هر لحظه فقط مقدارِ مشخصی متن را میبیند: پیامهای تو، جوابهای خودش و هر فایلی که پیوست کردهای. به این پنجرهی زمینه میگویند. هر چه بیرونِ این پنجره است، برای مدل وجود ندارد.
برای همین در یک گفتگوی خیلی طولانی، گاهی شرطی را که اولش گفتهای فراموش میکند. یا وقتی کتابی سیصدصفحهای را پیوست میکنی، ممکن است به فصلهای وسط کمتر توجه کند. پنجرهها در چند سالِ اخیر خیلی بزرگ شدهاند، ولی «دیدن» با «بهخوبی توجه کردن» یکی نیست. جزئیاتش را در پنجره متن یک میلیون توکنی نوشتهایم.
اگر حس کردی مدل حرفهای اولت را فراموش کرده، یک خلاصهی کوتاه از شرطها و تصمیمها بنویس و گفتگوی تازه را با همان شروع کن. این معمولاً از ادامه دادنِ یک گفتگوی خیلی بلند نتیجهی بهتری میدهد.
چرا مدلها فارسی را کمتر بلدند
دلیلِ اصلی ساده است: سهمِ فارسی در متنهایی که مدل خوانده خیلی کمتر از انگلیسی است. مدل همانقدر فارسی بلد است که فارسی دیده. نتیجه در عمل سه چیز است:
- جملهها گاهی ترجمهوار درمیآیند؛ دستورِ فارسی درست است ولی لحن، لحنِ یک متنِ ترجمهشده است.
- دانشِ محلی ضعیفتر است: قوانینِ اداری، اصطلاحهای بازار، ادبیاتِ معاصر.
- نیمفاصله و محاوره گاهی بههم میریزد.
مدلهای بزرگتر در فارسی هم بهترند، ولی فاصله هنوز هست. راههای کنار آمدن با آن را در محدودیتهای فارسی در هوش مصنوعی جمع کردهایم.
مدلهای باز در برابرِ بسته
بعضی سازندهها فقط از راهِ سرویسِ خودشان اجازهی استفاده میدهند: مدلِ بسته. بعضی دیگر فایلِ مدل را منتشر میکنند تا هر کس روی سرورِ خودش اجرا کند: مدلِ باز. انتخاب بینِ این دو بیشتر به کار بستگی دارد تا به کیفیت.
| معیار | مدلِ بسته | مدلِ باز |
|---|---|---|
| کیفیت در کارهای سخت | معمولاً بالاتر | نزدیک شده ولی اغلب کمی عقبتر |
| راهاندازی | نیاز ندارد | سرور و دانشِ فنی میخواهد |
| حریمِ داده | داده به سرویسدهنده میرود | داده پیشِ خودت میماند |
| شخصیسازی | محدود | کامل |
برای یک بیمارستان یا دفترِ حقوقی که نمیخواهد پرونده از سازمان بیرون برود، مدلِ باز جذاب است. مقایسهی کاملتر در متنباز یا بسته آمده.
مدلهای استدلالی که «فکر» میکنند
نسلِ تازهای از مدلها پیش از جواب دادن، مدتی «با خودشان» مینویسند: مسئله را تکهتکه میکنند، راهحل را امتحان میکنند و اشتباهشان را پیدا میکنند. بعد جوابِ نهایی را میدهند. این همان ایدهی استدلال زنجیرهای است، با این فرق که مدل آن را در آموزش یاد گرفته و لازم نیست تو ازش بخواهی.
این مدلها در ریاضی، کدنویسی و مسئلههای چندمرحلهای بهوضوح بهترند. ولی کندترند و گرانتر، و برای سؤالِ سادهای مثلِ «یک کپشن برای عکسِ شمال بنویس» هیچ برتریای ندارند. «فکر کردن» هم به معنای بیخطا بودن نیست؛ گاهی زنجیرهی استدلالِ کاملاً قانعکنندهای میسازد که به جوابِ غلط میرسد.
این پرامپت نشان میدهد چطور از مدل بخواهی مراحلِ کارش را آشکار کند تا خودت بتوانی چک کنی:
میخواهم برای مغازهام تصمیم بگیرم: اجارهی ماهانه را نقدی بدهم یا رهن را بیشتر کنم.
اطلاعاتِ من: [مبلغِ رهن، اجاره، و سودِ سپردهی بانکیام]
۱. مراحلِ محاسبه را قدم به قدم بنویس.
۲. هر فرضی که کردهای را جدا فهرست کن.
۳. در پایان بگو کدام عدد را باید خودم دوباره چک کنم.
این فقط برای فهمِ مسئله است؛ تصمیمِ نهایی را با مشاورِ مالی میگیرم.میتوانی همین حالا در چت امتحانش کنی. عددها را هم حتماً خودت یک بار با ماشینحساب بررسی کن؛ مدلهای زبانی در حساب کردن هنوز مطمئن نیستند.
اگر کنجکاوی ریشهی همهی اینها را ببینی، مقالهی معماریِ ترنسفورمر در سالِ ۲۰۱۷ نقطهی شروعِ این نسل از مدلها بود.
جمعبندی
مدلِ زبانیِ بزرگ ماشینی است که با خواندنِ حجمِ عظیمی از متن در حدسِ کلمهی بعدی استاد شده و بعد با نمونههای پرسش و پاسخ یاد گرفته مثلِ دستیار رفتار کند. حافظهاش به پنجرهی زمینه محدود است، دانشش تا تاریخِ آموزش است، و فارسی را به اندازهی سهمِ فارسی در دادهاش بلد است. مدلهای باز و بسته هر کدام جای خودشان را دارند، و مدلهای استدلالی برای مسئلههای سخت ارزش دارند، نه برای همهچیز.
مطالب مرتبط: