تفاوت یادگیری ماشین و یادگیری عمیق به زبان ساده
یادگیری عمیق زیرمجموعهی یادگیری ماشین است، ولی همیشه بهترین انتخاب نیست. با مثالهایی از دیوار و اسنپ میبینیم هر کدام کجا به کار میآید و کِی سراغِ روشِ سادهتر برویم.
یک مدیرِ محصول در یک استارتاپِ فروشِ آنلاین از تیمش خواسته بود «با یادگیری عمیق» پیشبینی کند کدام مشتری ماهِ بعد برنمیگردد. سه ماه بعد، یک مدلِ سادهتر که یک کارآموز در دو روز ساخته بود همان دقت را داشت و تازه میشد توضیح داد چرا فلان مشتری را پرخطر دانسته. این ماجرا خلاصهی تفاوت یادگیری ماشین و یادگیری عمیق است: یکی زیرمجموعهی دیگری است، ولی عمیقتر همیشه بهتر نیست.
این مقاله بدونِ فرمول توضیح میدهد این دو چه نسبتی با هم دارند، ماشین به چند شکل یاد میگیرد، و چطور بفهمی برای یک مسئلهی واقعی کدام را لازم داری.
سه دایرهی تودرتو
سادهترین تصویر این است: سه دایره که هر کدام داخلِ دیگری است. بزرگترین دایره هوش مصنوعی است، یعنی هر روشی که ماشین را به کارِ هوشمندانه وادارد؛ حتی یک برنامهی شطرنجِ قدیمی که با قانونهای دستنویس بازی میکند.
داخلِ آن، یادگیریِ ماشین است: روشهایی که قانون را کسی نمینویسد، ماشین خودش از روی مثالها پیدا میکند. و داخلِ یادگیریِ ماشین، یادگیریِ عمیق است: نوعِ خاصی از یادگیریِ ماشین که از شبکههای عصبیِ چندلایه استفاده میکند.
پس هر یادگیریِ عمیقی یادگیریِ ماشین است، ولی برعکسش نه. اگر میخواهی ببینی این دایرهها کنارِ دستهبندیهای دیگرِ هوش مصنوعی کجا مینشینند، انواع هوش مصنوعی تصویرِ کاملتری میدهد.
فرقِ اصلی: چه کسی ویژگیها را انتخاب میکند
فرض کن میخواهی قیمتِ یک آپارتمان در دیوار را پیشبینی کنی. در یادگیریِ ماشینِ کلاسیک، تو به ماشین میگویی به چه چیزهایی نگاه کند: متراژ، محله، سالِ ساخت، طبقه، آسانسور. ماشین از هزاران آگهی یاد میگیرد هر کدام چقدر روی قیمت اثر دارد.
حالا فرض کن میخواهی از روی عکسهای آپارتمان بفهمی بازسازیشده است یا نه. اینجا نمیتوانی ویژگیها را فهرست کنی. «کابینتِ نو» در پیکسلها چه شکلی است؟ یادگیریِ عمیق دقیقاً برای همین است: خودش از میلیونها پیکسل، ویژگیهای بهدردبخور را پیدا میکند. لایههای اول لبه و رنگ را میبینند، لایههای بعدی کاشی و کابینت را، و لایههای آخر «آشپزخانهی نوساز» را. چطور این لایهها کار میکنند را در شبکه عصبی چیست باز کردهایم.
سه شکلِ یادگیری، با مثالِ دیوار و اسنپ
هم یادگیریِ ماشینِ کلاسیک و هم عمیق میتوانند به یکی از این سه شکل یاد بگیرند. فرقشان در نوعِ دادهای است که به ماشین میدهیم.
نظارتشده: با جوابِ درست
به ماشین مثال همراه با جواب میدهیم. هزاران آگهیِ دیوار که دستهشان معلوم است، و ماشین یاد میگیرد آگهیِ تازه را خودش در دستهی درست بگذارد. تشخیصِ هرزنامه، پیشبینیِ قیمت و تشخیصِ بیماری از عکسِ پزشکی، همه از این نوعاند. بیشترِ کاربردهای تجاری همینجا هستند.
بدوننظارت: بدونِ جواب، دنبالِ الگو
اینجا هیچ جوابی نمیدهیم؛ فقط داده. ماشین خودش گروهبندی میکند. مثلاً یک فروشگاهِ اینترنتی مشتریهایش را از روی رفتارِ خرید به چند گروه تقسیم میکند: آنهایی که فقط در حراج میخرند، آنهایی که ماهانه و منظم میخرند، و بقیه. کسی از قبل نگفته بود این گروهها وجود دارند.
عیبش هم همین است: ماشین گروه میسازد ولی اسم و معنای گروه را نمیداند. ممکن است دستهای بسازد که برای کسبوکار هیچ معنایی ندارد. تفسیرِ نتیجه همیشه کارِ آدمی است که بازار را میشناسد، و بدونِ این مرحله، خروجیِ یادگیریِ بدوننظارت فقط چند عدد و رنگ روی نمودار است.
تقویتی: با آزمون و خطا
ماشین کاری انجام میدهد، پاداش یا جریمه میگیرد و رفتهرفته راهِ بهتر را پیدا میکند. مثالِ کلاسیکش بازی است. در دنیای واقعی، مسئلههایی مثلِ تخصیصِ راننده به مسافر در ساعتِ شلوغ، که هر تصمیم روی وضعیتِ چند دقیقهی بعد اثر دارد، از جنسِ همین نوع یادگیریاند؛ اینکه یک شرکتِ مشخص مثلِ اسنپ دقیقاً از کدام روش استفاده میکند را نمیدانیم و ادعا نمیکنیم.
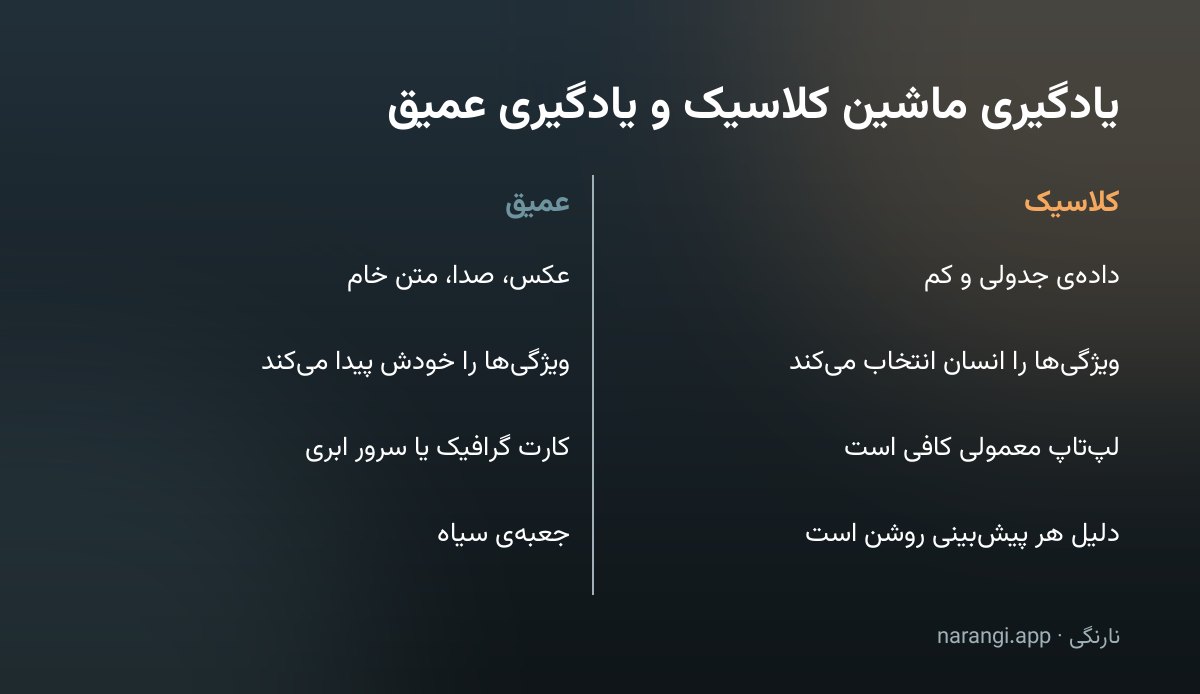
اگر دادهات جدول است (سطر و ستون، مثلِ اکسل)، اول با یادگیریِ ماشینِ کلاسیک شروع کن. اگر دادهات عکس، صدا یا متنِ آزاد است، یادگیریِ عمیق تقریباً همیشه برنده است. بیشترِ اشتباههای پرهزینه از جابهجا کردنِ همین دو شروع میشود.
تفاوت یادگیری ماشین و یادگیری عمیق در یک جدول
| معیار | یادگیریِ ماشینِ کلاسیک | یادگیریِ عمیق |
|---|---|---|
| حجمِ دادهی لازم | از چند صد تا چند ده هزار نمونه اغلب کافی است | معمولاً خیلی بیشتر، مگر از مدلِ ازپیشآموخته شروع کنی |
| نوعِ داده | جدولی و ساختاریافته | عکس، صدا، متن، ویدیو |
| سختافزار | یک لپتاپِ معمولی | کارتِ گرافیکِ قوی یا سرورِ ابری |
| زمانِ آموزش | ثانیه تا چند ساعت | ساعت تا هفته |
| تفسیرپذیری | بالا؛ میشود گفت کدام ویژگی مؤثر بود | پایین؛ جعبهی سیاه |
| انتخابِ ویژگی | با انسان | خودکار |
ردیفِ تفسیرپذیری را دستکم نگیر. اگر بانکی درخواستِ وامِ کسی را رد کند، باید بتواند بگوید چرا. مدلی که فقط میگوید «رد» و دلیلش را نمیداند، در چنین جاهایی دردسرساز است، هر چقدر هم دقیق باشد. مدخلِ یادگیری عمیق در ویکیپدیا به همین مسئلهی توضیحپذیری هم پرداخته است.
کِی یادگیریِ عمیق لازم نیست
اینجا باید موضع گرفت، چون هیاهو زیاد است. یادگیریِ عمیق را انتخاب نکن وقتی:
- دادهات کم است. چند صد ردیف سابقهی فروشِ یک مغازهی لوازمِ خانگی، برای شبکهی عمیق کم است و مدل فقط همان داده را حفظ میکند.
- باید دلیل بیاوری. تصمیمهای مالی، استخدامی و اداری که پاسخگویی لازم دارند.
- یک قانونِ ساده جواب میدهد. اگر «هر سفارشِ بالای فلان مبلغ را دستی چک کن» کافی است، هیچ مدلی لازم نیست.
- بودجه و زمان محدود است. هزینهی سختافزار و نیرویِ متخصص در یادگیریِ عمیق خیلی بیشتر است.
و برعکس، وقتی کار با عکس، صدا یا متن است، سراغِ روشهای کلاسیک رفتن معمولاً وقت تلف کردن است. خوشخبری اینکه برای این نوع کارها معمولاً لازم نیست از صفر مدل بسازی؛ مدلهای آماده را میشود با دادهی خودت تنظیم کرد، که در فاینتیونینگ چیست توضیح داده شده.
یک پرامپت برای انتخابِ روشِ درست
اگر مسئلهای داری و نمیدانی کدام روش به کارت میآید، یک دستیارِ هوش مصنوعی میتواند نقطهی شروعِ خوبی باشد. در چت این را بنویس و جاهای خالی را پر کن:
میخواهم این مسئله را با یادگیریِ ماشین حل کنم: [مسئله را بنویس]
دادهای که دارم: [نوع، مثلاً جدولِ اکسل یا عکس] و حدوداً [تعداد] نمونه.
آیا جوابِ درست برای دادهها دارم؟ [بله/نه]
باید بتوانم دلیلِ هر پیشبینی را توضیح بدهم؟ [بله/نه]
بگو یادگیریِ ماشینِ کلاسیک مناسبتر است یا عمیق، و چرا.
یک روشِ سادهتر بدونِ یادگیریِ ماشین هم پیشنهاد بده اگر وجود دارد.خطِ آخر عمداً آنجاست؛ بهترین مدل گاهی مدلی است که لازم نیست ساخته شود. جوابِ دستیار را نظرِ اول بدان، نه حکمِ نهایی؛ برای پروژهی جدی نظرِ یک متخصصِ داده را هم بگیر.
جمعبندی
یادگیریِ عمیق نوعی یادگیریِ ماشین است، و یادگیریِ ماشین نوعی هوش مصنوعی. فرقِ عملیِ آنها در این است که در روشِ کلاسیک انسان میگوید به چه نگاه کن، و در روشِ عمیق ماشین خودش پیدا میکند. برای دادهی جدولی و کم، کلاسیک ارزانتر و شفافتر است. برای عکس و صدا و متن، عمیق برنده است. هر سه شکلِ یادگیری، نظارتشده، بدوننظارت و تقویتی، در هر دو ممکناند.
مطالب مرتبط: